


Дві моделі, навчені на тих самих даних, можуть засвоїти різні закономірності через крихітні відмінності на старті навчання. Дослідники з Сіднейського університету пояснили, чому навіть контрольований процес не завжди дає однаковий результат
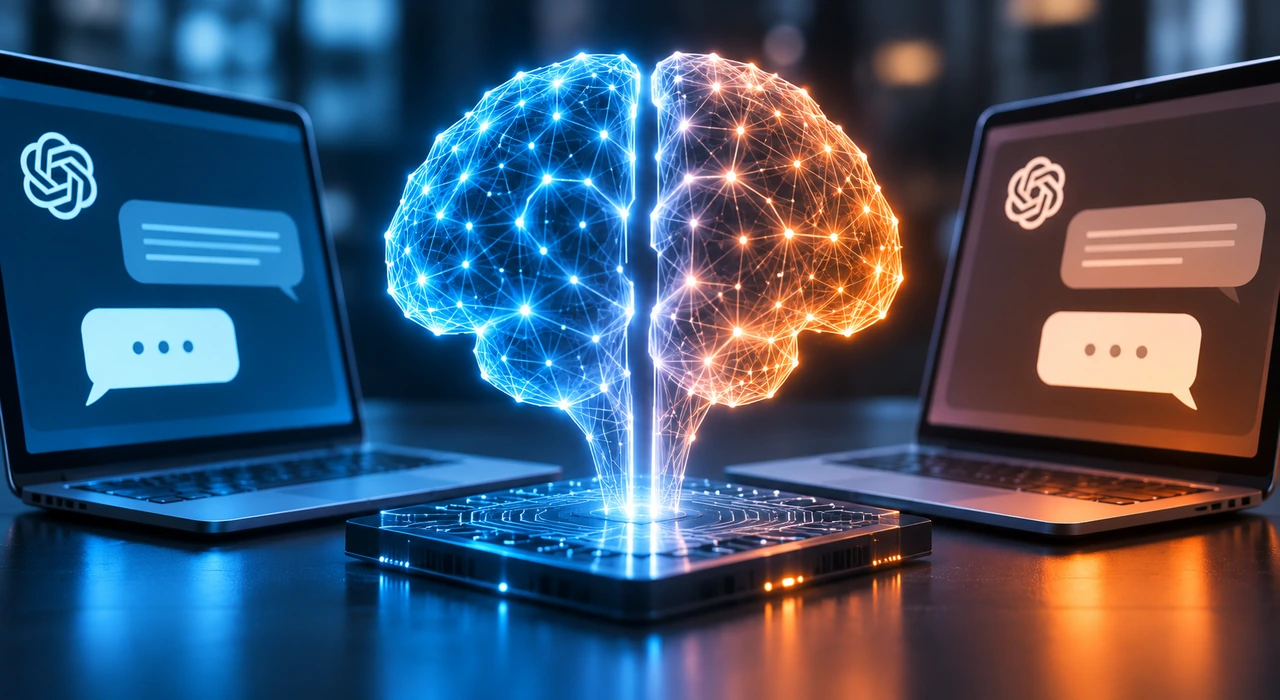
Фото: ChatGPT
Поширене уявлення про навчання ШІ таке: якщо використати однакові дані, архітектуру та налаштування, модель має прийти до того самого рішення. Нове дослідження показує, що це не завжди так. Невелика зміна початкових параметрів — значень, із яких алгоритм починає навчання, — може спрямувати модель до іншого набору внутрішніх рішень.
Під час тренування нейромережа багаторазово коригує параметри, щоб краще виконувати поставлене завдання. Ці коригування не відбуваються у простому прямолінійному просторі: система має величезну кількість можливих конфігурацій, а шлях до прийнятного результату залежить від стартової точки. Дослідники описують цей процес як рух складним ландшафтом, де дуже близькі початкові стани можуть привести до різних «долин» оптимізації.
Мала відмінність на старті — інша модель після навчання
Команда вивчала математичні властивості навчання нейромереж і виявила, що навіть мінімальні зміни ініціалізації здатні посилюватися впродовж тренування. У підсумку моделі можуть по-різному представляти ті самі дані та відрізнятися в поведінці, хоча процес навчання загалом був контрольованим.
Це не означає, що нейромережі випадково змінюють відповіді під час кожної взаємодії. Йдеться про інший етап: формування моделі. Після завершення навчання конкретна версія може відповідати стабільно в межах заданих налаштувань, але повторне навчання з майже ідентичними умовами може створити систему з іншими внутрішніми властивостями.
Читайте також: ШІ навчили працювати на енергії світла: навіщо це потрібно
Чому результати не завжди можна відтворити
Відтворюваність важлива для науки та розробки комерційних систем. Якщо зміна стартових значень призводить до іншого результату, одного запуску навчання може бути недостатньо, аби оцінити надійність моделі. Різні версії можуть по-різному реагувати на рідкісні приклади, неоднозначні запити або ситуації, які не були добре представлені в навчальних даних.
Для розробників це означає потребу перевіряти не лише одну модель, а кілька варіантів, створених із різними початковими параметрами. Якщо вони демонструють різний рівень точності чи безпечності, це сигнал про нестабільність процесу. Тестування кількох запусків допомагає помітити відмінності, які не видно під час оцінки лише найуспішнішої версії.
Що це змінює для оцінювання ШІ
Дослідження додає важливе застереження до порівняння моделей. Результат тесту може залежати не лише від обсягу даних, кількості параметрів чи обчислювальних ресурсів, а й від початкового стану навчання. Тому компаніям і незалежним оцінювачам корисно публікувати більше подробиць про процедуру тренування та перевіряти, чи зберігається результат у повторних запусках.
Це особливо важливо в системах, де помилка може мати практичні наслідки — наприклад, під час добору інформації, аналізу документів або автоматизації робочих процесів. Якщо дві моделі з одного набору даних поводяться не однаково, користувачам потрібні зрозумілі межі застосування та контроль людини за важливими рішеннями.
Автори роботи не стверджують, що штучний інтелект неможливо зробити надійним. Вони показують, що стабільність не можна припускати лише через однакові дані та налаштування. Її потрібно вимірювати: повторювати навчання, зіставляти отримані моделі та перевіряти, чи не зникає бажана поведінка за незначних змін процесу.
Ознайомтеся з іншими популярними матеріалами:
Visa відкрила свою мережу для стейблкоїна Western Union
НБУ перевірив стійкість банків: 11 установам посилили вимоги до капіталу
НБУ оновив правила роботи банків із депозитними сертифікатами
Джерело: Nature Machine Intelligence.



 Telegram
 Viber


